AIエージェント時代のデータマート ― 静的マートの限界と、目的に応じた特徴量の自動生成
- 特徴量
- データ加工
- 生成AI
- 自動化
 dotData
AIエージェントの時代には、データマートの作り方を見直す必要があります。分析の目的ごとに必要な属性を、1つの静的なマートに足し続けるやり方では、エージェントが分析を進めるスピードに追いつけないからです。
dotDataは、分析の目的に関係するデータ上のパターンである「特徴量」を、AIエージェントに定量的な根拠を与えるデータとして捉え直しています。特徴量は目的によって変わります。そのため、全社で共有する標準的なデータと、目的に応じて特徴量を自動生成する仕組みを分けて設計することが重要になります。
本記事では、次の内容を解説します。
AIエージェントが自社の分析で精度を出すには、3種類の知識をそろえる必要があります。
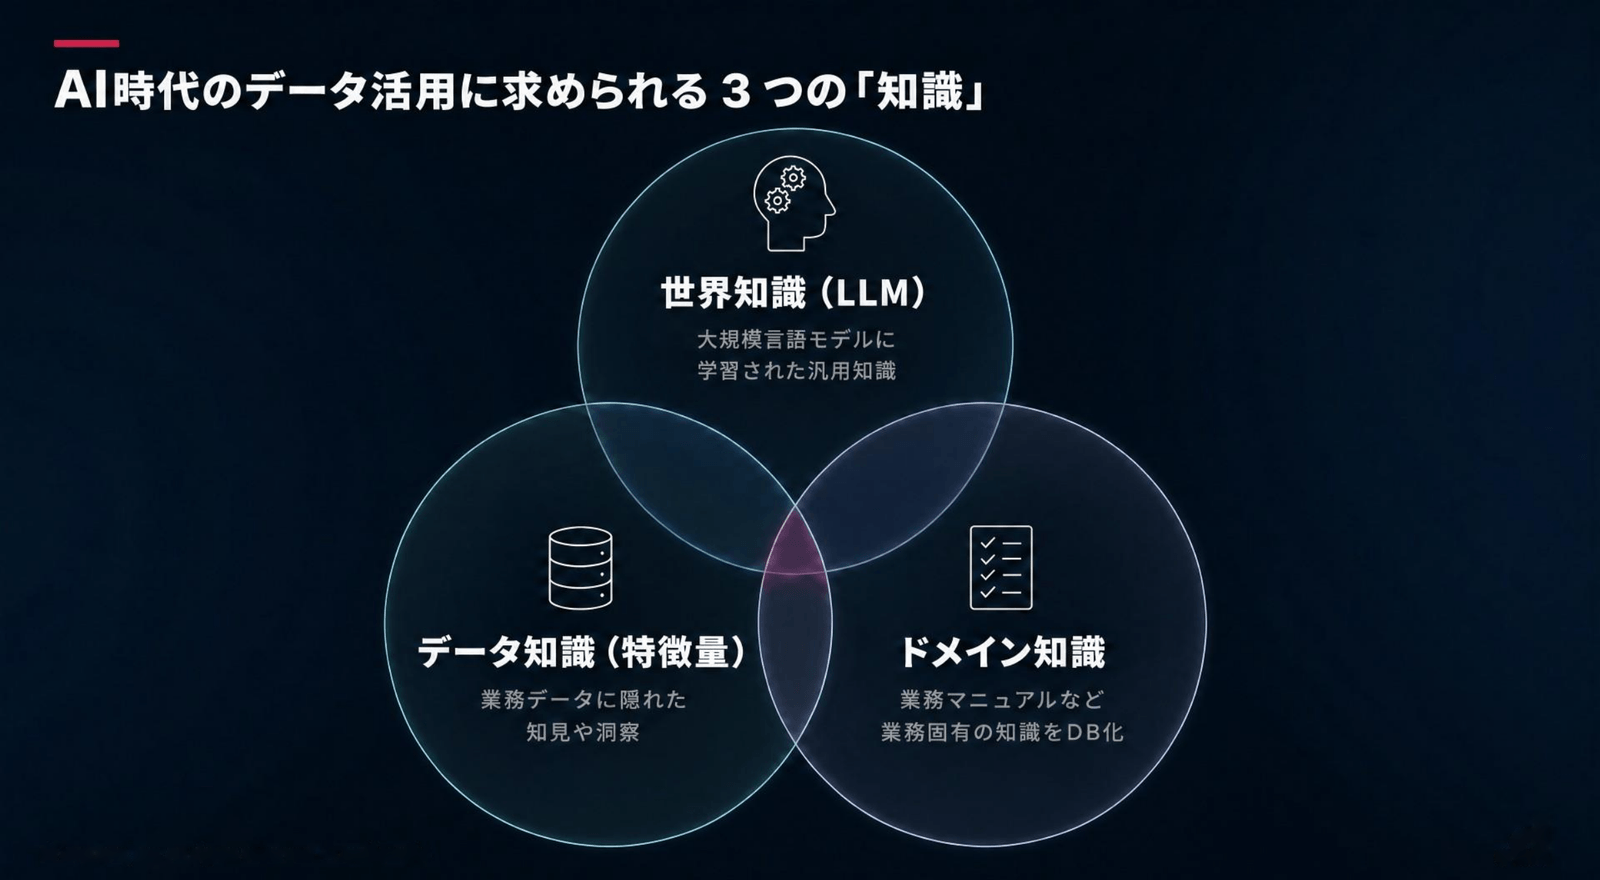
データ分析の分野では、何十年にもわたって「データドリブン」が重視されてきました。データの中に、人の経験や知識だけでは得られない知見があるからです。AIエージェントの時代でも、この点は変わりません。
AI-Ready Dataとはでは、データに意味(定義と文脈)を与える考え方を解説しました。本記事では、3つの知識のうち、データからの知識を扱います。
特徴量の役割は、機械学習モデルやBIの入力となる変数から、AIエージェントに定量的な根拠を与えるデータへと広がりつつあります。特徴量が重要なのは、分析の答えが生のデータそのものではなく、目的に関係するパターンの中にあるからです。同じ顧客データでも、どのパターンを取り出すかによって、予測の精度も、打つべき施策も変わります。dotDataは、2018年にNECからのスピンアウトとして創業して以来、この特徴量の設計を自動化する技術に取り組んできました。特徴量エンジニアリングの基本は、解説:機械学習のための特徴量設計で紹介しています。
dotDataは、特徴量を「分析の目的に関係するデータ上のパターン」と捉えています。
特徴量は、元になるデータの種類によって作り方が変わります。代表的な例は次のとおりです(いずれも説明のための例です)。
| データの種類 | 特徴量の例 | 詳しい解説 |
|---|---|---|
| カテゴリ変数(商品カテゴリ、地域など) | カテゴリごとの出現頻度、購買に占めるカテゴリ別の比率 | カテゴリ属性に対する特徴量設計 |
| 日付・時刻 | 曜日別の利用比率、前回購入からの経過日数 | 時系列モデルの手法と時間データの特徴量設計 |
| 時系列・トランザクション | 直近30日の購買回数、過去90日の利用額の移動平均、利用回数の増減 | 時系列データの特徴量設計 – パート2 |
| テキスト(問い合わせ履歴、レビューなど) | 問い合わせ内容の意味を表すラベル、話題ごとの出現件数 | dotData TextSense |
時系列やトランザクションのデータでは、「どの期間で」「どう集計するか」の組み合わせで候補が大きく増えます。この組み合わせを人手で網羅するのは難しく、自動生成が効果を発揮しやすい領域です。
これまで特徴量は、主に機械学習モデルの予測精度を高めるための説明変数や、BIの入力として使われてきました。AIエージェントの時代には、新しい役割が加わります。エージェントの分析・仮説・アクションに定量的な根拠を与え、その精度を高めるデータとしての役割です。dotDataは、特徴量を定量側のAI-Ready Dataと位置づけています。
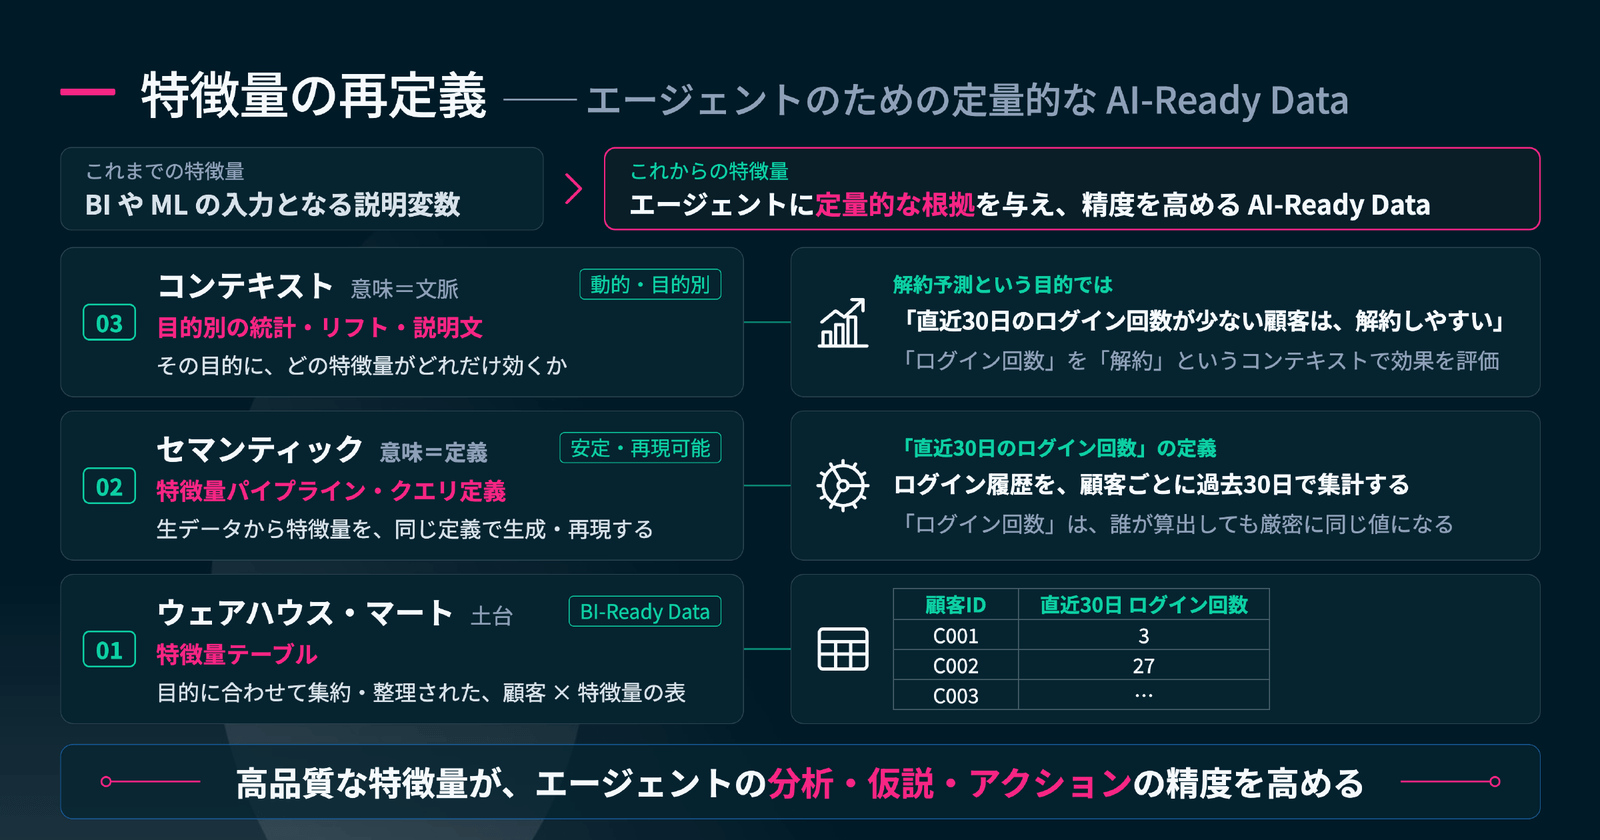
AI-Ready Dataとはで紹介した3層構造(土台/セマンティック/コンテキスト)は、特徴量にもそのまま当てはまります。ここでは、目的を「解約予測」、特徴量を「直近30日のログイン回数」とした例で説明します(数値はすべて説明のための例です)。
| 層 | 特徴量での中身 | 例:解約予測と「直近30日のログイン回数」 |
|---|---|---|
| ③コンテキスト(意味=文脈) | 目的別の統計、リフト(その特徴を持つ顧客で、目的の事象が全体の平均の何倍起きやすいか)、説明文。その目的に、どの特徴量がどれだけ効くか | 解約予測という目的では、「直近30日のログイン回数が少ない顧客は解約しやすい」 |
| ②セマンティック(意味=定義) | 特徴量パイプライン、クエリ定義。生データから特徴量を同じ定義で生成・再現する | ログイン履歴を、顧客ごとに過去30日分集計する。誰が算出しても同じ値になり、毎月の新しいデータにも同じ定義で再生成できる |
| ①土台(BI-Ready Data) | 特徴量テーブル。目的に合わせて集約・整理した「顧客×特徴量」の表 | 顧客C001はログイン3回、顧客C002は27回 |
この表で重要なのは、③コンテキストの中身が目的によって変わる点です。同じ「ログイン回数」でも、解約予測では、ログイン回数が減った顧客が注目すべき対象になります。一方、ある商品の購買予測では、ログイン回数が増えた顧客が、購入しそうな顧客として注目されるかもしれません。特徴量の意味は、目的、つまりコンテキストによって決まります。
なお、この表の③は事前に計算しておく統計ですが、エージェントが問いに応じて、目的に合う統計と説明を実行時に受け取るという意味で、コンテキスト層にあたります。
BIや機械学習の時代には、データマートや特徴量ストア(フィーチャーストア)を先に作り、全社で共有するのが定石でした(特徴量ストアについてはDatabricksの特徴量ストアとAutoMLの記事で解説しています)。
販売、顧客、商品、キャンペーン、在庫などのデータを結合し、横に長い統合分析テーブルを作ります。日本では「大福帳」と呼ばれることもある形式です。このテーブルを最初に整備しておき、さまざまな分析テーマで使い回します。データマートを含むデータ基盤の構成については、データ活用基盤とは?で解説しています。
このアプローチには合理性があります。
特に、重要な指標や定常レポートを支えるマートの役割は、AIエージェントの時代になっても変わりません。問題が生じるのは、分析テーマが増えるたびに、そのテーマのための属性(列)をマートに足していく運用です。
分析のテーマが増えるほど、属性を足し続ける静的なマートは、システムと組織の負債になっていきます。たとえば、dotDataが支援している欧州の通信事業者では、10年以上かけてマートが数万列に膨らみ、パイプラインの修正と再計算の負担が大きくなっていました。この章では、負債が生まれる理由を、分析スピードの変化と、悪循環を生む4つの要素に分けて説明します。データマートを含むデータ基盤の基本的な構成は、データ活用基盤とは?で解説しています。

AIによって、分析のスピードは大きく上がります。dotDataは、その変化を次のようなイメージで捉えています(実測値ではなく、加速の方向を示すイメージです)。かつて数カ月かかっていた分析が、自動化ツールによって1カ月に、AIの支援によって1週間に、エージェントによって1日に、と短くなっていけば、取り組める分析テーマは次々に増えていきます。テーマが増えるたびに属性を足していけば、マートは横に伸び続けます。
前述の通信事業者のように列が数万に達すると、次のような悪循環が生まれます。
この悪循環は、1に戻って繰り返されます。AIエージェントの時代に分析のサイクルが速くなれば、このアプローチのままでは、データの側がボトルネックになります。エージェントがどれほど賢くても、必要なデータが用意できなければ、分析は進みません。
特徴量は目的によって変わるため、すべての分析テーマで共有できる理想のマートは存在しません。
先ほどのログイン回数の例のように、同じデータでも、目的によって注目すべきパターンは違います。必要な属性そのものも、目的ごとに異なります。
1つの共有マートで、これらすべての目的に応えようとすると、目的の数だけ列が増えていきます。どの目的にも通用するデータを事前に用意しておくことはできない、という考え方はAI-Ready Dataとはでも紹介しました。dotDataは、特徴量のような定量的なデータも、同じように目的に依存すると考えています。
ここから導かれるのは、全社で共有すべき本質的な属性と、目的ごとに必要な属性を分けて扱う、という考え方です。前者は共有し、後者は目的に応じて自動で生成します。
dotDataは、共有する標準データと、目的ごとに生成する特徴量を分け、目的変数を起点に特徴量を自動生成するアーキテクチャを提案しています。目的変数とは、分析の目的をデータで表したもの(例:解約したかどうか、成約したかどうか)です。

全社で共有するのは、作り込んだ巨大なマートではありません。次のような軽い標準データです。
標準データは、新しく作り込む必要はありません。DatabricksやSnowflakeなどのデータ基盤上で、すでに整備されているテーブルを起点にできます。dotData Feature Factoryは、こうした複数のテーブルとテーブル同士の関係を入力にして、特徴量を生成します。
分析テーマごとに、目的変数を標準データに接続すると、その目的に合った特徴量が自動で生成されます。流れは次の4ステップです。
ステップ1と2は、特徴量自動設計による自動化です。ステップ3と4は、特徴量とLLMを組み合わせた意味づけです。生成された特徴量は、統計的な裏付けのある事実として、LLMやエージェントに渡されます。
特徴量を自動生成する方法には、主に次のようなものがあります。
従来の特徴量エンジニアリングは、分析者の手作業によるプロセスでした。分析者が経験と知識をもとに仮説を立て、PythonやSQLでデータの抽出・集計・変換の処理を書いて特徴量を作成し、機械学習モデルで効果をテストします。この作業には時間がかかるため、1つのテーマで検証できる仮説の数には限りがありました。目的に応じた特徴量の自動生成は、このプロセスの考え方を次のように変えます。
| 観点 | 手作業の特徴量エンジニアリング | 目的に応じた特徴量の自動生成 |
|---|---|---|
| 仮説の出し方 | 分析者の経験と知識に基づいて、候補を選ぶ | アルゴリズムが複数のテーブルを横断して、パターンを網羅的に探索する |
| 作業のプロセス | 特徴量ごとに、抽出・集計・変換の処理を書き、モデルでテストする | 目的変数を与えると、特徴量の生成から評価までを自動で行う |
| テーマが増えたとき | 分析者の作業時間が、テーマの数に比例して増える | 目的変数を差し替えて、同じ手順を繰り返せる |
| 再現性 | 担当者ごとのコードに依存しやすい | 特徴量パイプラインとして、同じ定義で再生成できる |
人の経験と知識が不要になるわけではありません。どの目的変数を設定するか、生成された特徴量をどう解釈して施策につなげるかは、引き続き人が判断します。自動生成は、仮説の候補を広げ、作業の効率を高めるための手法です。
このアーキテクチャでdotDataが目指すのは、データチームの工数を、分析テーマの数から切り離すことです。従来のアプローチでは、テーマが増えるほど、属性の追加と保守の工数が増えていきました。目的に応じて特徴量を自動生成する仕組みでは、テーマごとに人手で属性を追加・保守する負担が減り、保守の中心は共有する標準データに移ると、dotDataは考えています。属性を設計し、試し、評価するサイクルも短くなり、分析のPDCAを速く回せるようになります。
目的変数を差し替えると、生成される特徴量とレポートが変わります。そのため、1つの仕組みで多くの分析テーマに対応できます。dotDataは、2026年7月1日のウェビナー「AI Agentの新トレンド〜精度を決める『AI-Ready Data』〜」で、ローンの不履行リスクを目的変数にしたデモを通じて、この使い方を紹介しました。以下では、小売と金融の2つの例で説明します。
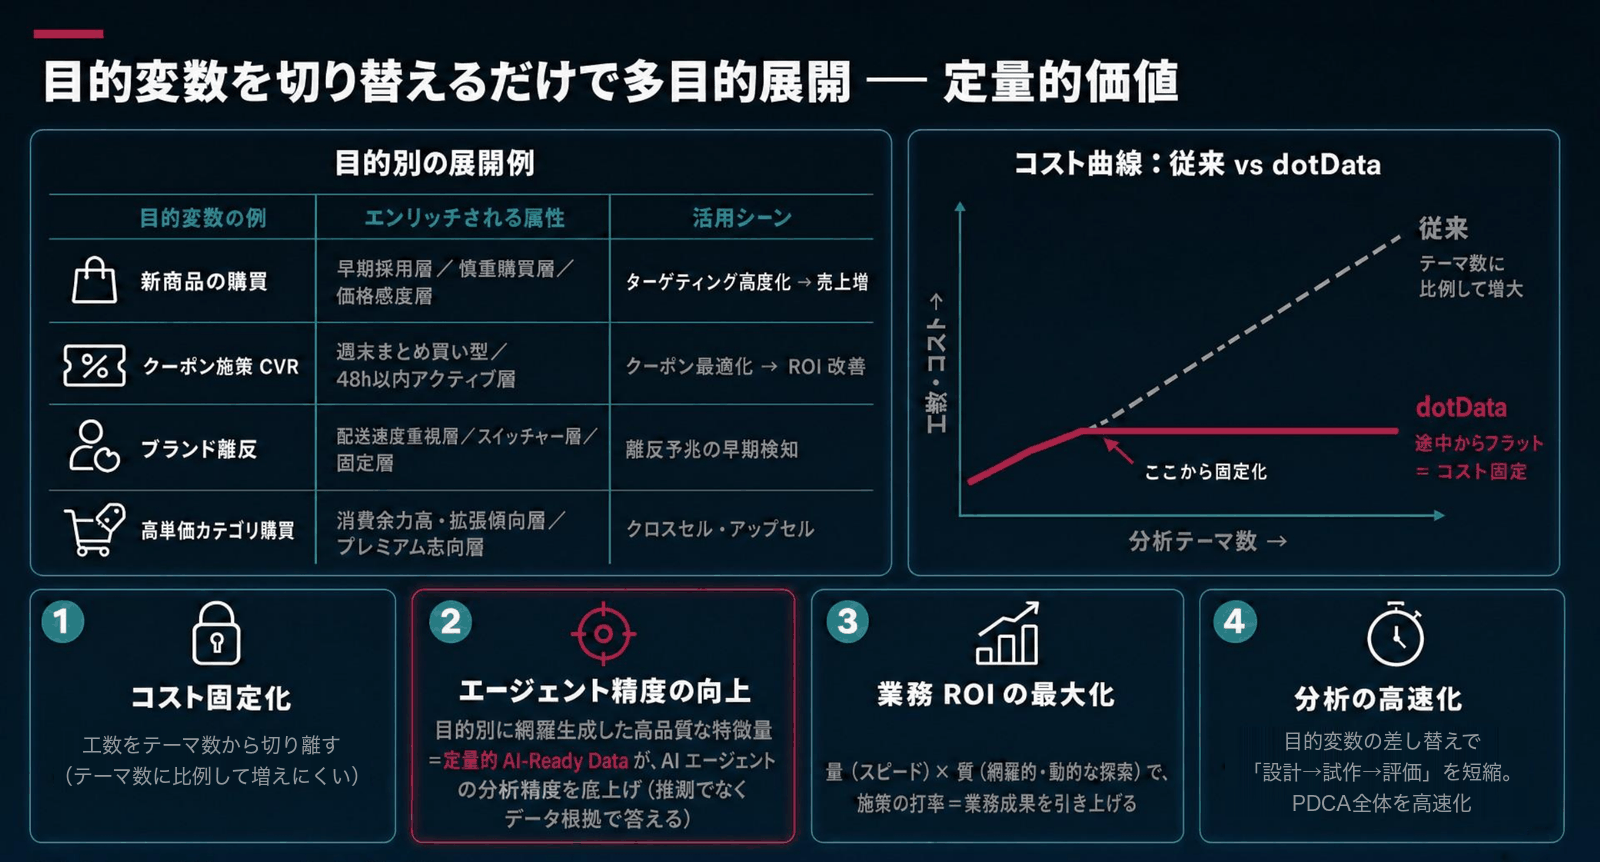
次の表は、小売の分析を想定した例です(いずれも説明のための例です)。
| 目的変数の例 | 生成される属性のイメージ | 活用シーン |
|---|---|---|
| 新商品の購買 | 早期に購入する層、慎重に購入する層、価格に敏感な層 | ターゲティングの高度化 |
| クーポン施策への反応 | 週末にまとめ買いする層、配布後すぐに反応する層 | クーポン配布の最適化 |
| ブランドからの離反 | 配送の速さを重視する層、ブランドを乗り換えやすい層 | 離反の予兆の早期検知 |
| 高単価カテゴリの購買 | 消費の余力があり購買の幅を広げている層、上質志向の層 | クロスセル・アップセル |
金融の与信を例にとります。ローンの不履行リスクを目的変数にすると、リスクの高い顧客と低い顧客の特徴が抽出されます。そこに業務の文脈を与えると、地域のリスクに応じた与信、返済の余力という観点での審査、生活基盤の異なる顧客層ごとの施策といった解釈や提案が導かれます。
ここで目的変数を、別のローン商品の不履行リスクに差し替えれば、同じ仕組みで別の商品の分析ができます。新規のローン申込みのように、まったく異なるテーマに切り替えることもできます。目的変数を差し替えるだけで、特徴量が変わり、レポートの内容も変わります。
この仕組みは、AIが人の分析を支える「AI拡張型」の分析にも、分析そのものをAIエージェントに任せる「エージェント駆動型」の分析にも、基盤になります(3つの段階についてはAIエージェントを活用したデータ分析の現在地で解説しています)。
「LLMに直接データを渡して分析させればよいのではないか」という疑問もよく聞かれます。dotDataの考えは、統計的に確定させるべき部分を先に特徴量として出し、それをLLMに渡すほうが、分析の精度が上がるというものです。違いは2つあります。
LLMに解約の分析を任せると、LLMはデータの項目を見て推論し、人の勘のように、5個から10個程度の要因を選んで計算します。dotDataの特徴量自動設計のアルゴリズムは、複数のテーブルから、目的ごとに数百から数千のパターンを統計的に探索し、その中から目的との関係が強いものを選びます。探索の網羅性が違うため、見つかる要因の質も変わります。
アクセスログのような縦に長いトランザクションデータは、そのままではLLMに入力できません。そのため、LLMにデータを集計・変換するクエリを書かせることになりますが、加工が複雑になるほど誤りが入り込みやすくなります。特徴量パイプラインは、定義に従って同じ計算を再現するため、計算の正確性を保てます。
網羅的に探索され、正確に計算された特徴量をLLMに渡すことで、エージェントにコンテキストを与えて精度を高めるのと同様の効果を、定量の側で得られると、dotDataは考えています。
dotDataは、特徴量自動設計の技術を核に、AIエージェントのための定量的なデータを、目的ごとに生成することに取り組んでいます。
2026年12月9日(水)12:00〜13:00には、dotData CEOの藤巻が登壇するウェビナー「AI Agentの価値は、データで決まる 〜北米で起きているデータ基盤の再定義〜」を開催します。AIエージェントの時代にデータ基盤をどう考えるべきかを、北米の動向を交えてお話しします。詳細・お申し込みはウェビナーのページをご覧ください。
dotDataは、dotData Feature FactoryとdotData Insightを通じて、この考え方の実装に取り組んでいます。2026年12月9日のウェビナー「AI Agentの価値は、データで決まる」では、AIエージェントの時代のデータ基盤について解説します。
AIエージェントによるデータ分析の全体像はAIエージェントを活用したデータ分析の現在地で、データの意味を整える考え方はAI-Ready Dataとはで解説しています。
特徴量エンジニアリングとは、生のデータから、分析の目的に役立つ変数(特徴量)を設計・作成する作業のことです。たとえば購買履歴から「直近30日の購買回数」や「前回購入からの経過日数」を作るのが典型例です(数値は例です)。機械学習モデルの精度を左右する工程として重視され、長く分析者の経験に頼る手作業で行われてきました。dotDataは2018年に、この工程を自動化するAutoML製品dotData Enterpriseの提供を始めました。基本と設計の方法は、解説:機械学習のための特徴量設計で詳しく紹介しています。
まず目的変数を正しく定義し、そのうえで特徴量の候補を広く探索して、効くものを選ぶことが基本です。主なポイントは次の4つです。
時間データの扱い方は、時系列モデルの手法と時間データの特徴量設計で解説しています。
大きく、オープンソースのライブラリ、データ基盤の機能、商用製品の3種類があります。オープンソースでは、Pythonで使える特徴量生成のライブラリが公開されています。データ基盤では、Databricksなどが作成した特徴量を管理・共有する特徴量ストアの機能を提供しています(Databricksの特徴量ストアとAutoMLの記事)。商用製品では、dotDataが、特徴量自動設計を核にしたdotData Feature FactoryとdotData Enterpriseを提供しています。選ぶ際は、扱えるテーブルの数と関係の複雑さ、生成した特徴量を再現できるか、結果を業務の言葉で説明できるか、を確認するとよいでしょう。
主な用途が違います。データマートは、特定の業務やBIでの利用に向けて、データを集計・整理したものです。特徴量ストアは、機械学習モデルの入力となる特徴量を管理し、学習と予測の両方で同じ特徴量を使えるようにする仕組みで、Databricksなどのデータ基盤が機能として提供しています。どちらも、事前に作って全社で共有するという点では共通しています。データマートの位置づけはデータ活用基盤とは?で、特徴量ストアはDatabricksの特徴量ストアとAutoMLの記事で解説しています。
不要にはなりません。重要な指標や定常的なレポートを支えるマートには、確定した定義による正確さが求められるため、引き続き必要です。見直すべきなのは、分析テーマごとに必要な属性を、静的なマートに足し続ける運用です。dotDataが支援している欧州の通信事業者では、この運用を10年以上続けた結果、マートが数万列に膨らんでいました。こうした目的別の属性は、目的に応じた自動生成に移すことをおすすめします。データ基盤全体の構成は、データ活用基盤とは?をご覧ください。
目的変数との関係の強さで選び、ビジネス上の意味が説明できるかで評価します。具体的には、目的に対する統計やリフトといった定量的な情報で効き目を確認します。たとえば「リフト2.1倍」は、その特徴を持つ顧客で目的の事象が平均の2.1倍起きやすいことを表します(数値は例です)。そのうえで、説明文を付けて業務の言葉で解釈できるようにします。同じ定義で新しいデータからも再生成できることが、継続的に使ううえでの前提です。特徴量の自動選択の例は、特徴量自動選択による顧客リスクの見積もりで紹介しています。
業務の目的を、データで観測できる事象として表現します。解約、成約、不履行、購買などが典型例です。どの単位(顧客、製品、店舗など)で、どの期間に起きた事象を対象にするかを、あわせて決めます。たとえば「顧客ごとに、2026年11月中に解約手続きをしたかどうか」のように、単位・期間・事象をそろえて1行で書ける形にします(例です)。同じ「解約」でも定義によって結果が変わるため、定義の考え方はAI-Ready Dataとはも参考にしてください。目的変数の基本は解説:機械学習のための特徴量設計で解説しています。
分析の単位(顧客IDなど)と、テーブル同士の関係(ER)が定義された標準的なデータがあれば始められます。すべてのデータを完璧に整える必要はありません。DatabricksやSnowflakeなどのデータ基盤に、販売・顧客・商品といった領域ごとのテーブルがあれば、それを起点にできます。まず1つの分析テーマで目的変数を定義し、そこから適用範囲を広げていく進め方が現実的です。複数のテーブルから特徴量を作る仕組みは、dotData Feature Factoryの製品ページで紹介しています。