AI-Ready Dataとは? AI時代に求められるデータ整備 ― BI-Ready Dataとの違いと、AIエージェントの精度を決める3層構造
- データ加工
- データ分析
- 生成AI
- AI業界
 dotData
AI-Ready Data(AI-Readyデータ、AI Ready Dataとも表記)とは、特定の用途に対して、AIが正しく使える状態にあるデータのことです。調査会社のGartnerは、AI-Readyなデータを「そのユースケースを代表するデータ」と位置づけ、一度整えれば終わりではなく、用途ごとに継続的に整え続ける実践だとしています。
生成AIやAIエージェントの活用が広がるなかで、「データはきれいに整備されているのに、エージェントが正しく答えない」という声を、dotDataは企業との議論の中で多く聞くようになりました。dotDataは、その原因がデータの「意味」の不足にあると考えています。BIのために整えたデータ(BI-Ready Data)はAI-Ready Dataの土台ですが、それだけでは足りません。データの上に、意味を「定義」として固定するセマンティック層と、問いごとに「文脈」を渡すコンテキスト層を重ねることが欠かせません。
本記事では、次の内容を紹介します。
AI-Ready Dataとは、特定の用途に対して「AIが正しく使える」状態にあるデータを指す概念で、データそのものの品質だけを指すものではありません。AI-Readyかどうかは、データ単体ではなく、そのデータをどう使うかによって決まります。
AI-Readyな状態とは、AIに任せる用途が決まり、その用途に合ったデータと、データの意味がそろっている状態です。Gartnerの説明とdotDataの整理を合わせると、次の5つが満たされた状況だといえます。
AIにおけるデータセットとは、AIが学習・評価・実行のために使う、目的に沿って集めたデータのまとまりです。機械学習では、モデルを作るための学習用データと、精度を確かめるための評価用データを分けて用意します。生成AIやエージェントでは、モデル自体はすでに学習済みのことが多く、AI-Ready Dataとして整える対象の中心は、エージェントが実行時に参照するデータになります。具体的には、データベースのテーブル、社内文書、指標の定義などです。
Gartnerの説明に沿うと、AI-Ready Dataに必要な条件は、用途への整合、代表性、適格性の確認、統制、そしてそれらを支えるメタデータと継続的な実践です。Gartnerは2025年2月の発表で、次のように述べています(Gartner, 2025年2月26日)。
“The data must be representative of the use case, of every pattern, errors, outliers and unexpected emergence that is needed to train or run the AI model for the specific use.”
(データは、そのユースケースを代表していなければならない。つまり、特定の用途に向けてAIモデルを学習・実行するのに必要なあらゆるパターン、エラー、外れ値、予期せぬ事象までを含んでいなければならない)
同じ発表では、AI-Readyなデータを「メタデータを活用できることを前提に、データを用途に整合させ(align)、適格性を確認し(qualify)、統制する(govern)プロセスであり実践」と説明しています。Gartnerの説明を条件として整理すると、次のとおりです。
| 条件 | 内容 |
|---|---|
| 用途への整合(align) | AI-Readyかどうかは、データがどう使われるかで決まる。まず用途にデータを合わせる |
| 代表性 | その用途に必要なパターンを、エラーや外れ値も含めて表している |
| 適格性の確認(qualify) | そのデータが用途に適しているかを確かめる |
| 統制(govern) | 用途ごとに、データの扱いのルールを決めて運用する |
| メタデータの活用 | 整合・確認・統制を行うための前提として、メタデータが使える |
| 継続的な実践 | 一度整えれば終わりではなく、用途ごとに整合・確認・統制を続ける |
dotDataは、これらに加えて、データの「意味」を整えることを、エージェントの時代に特に欠かせない条件だと考えています。指標や用語の定義(セマンティック)と、問いごとの文脈(コンテキスト)です。この「意味の層」については、後の章で詳しく説明します。
AI-Readyかどうかは用途ごとに決まるため、どの用途にも通用する「汎用のAI-Ready Data」はありません。Gartnerも、「データを一般的に、あるいは事前にAI-Readyにする方法はない。AIへの準備ができているかどうかは、そのデータがどう使われるかによって決まる」と述べています(Gartner)。
ガートナージャパンも2026年5月の発表で、社内データを一元管理し、全体にガバナンスをかけ、メタデータを付与すればAI-Readyになる、という考え方を誤りとして挙げています。そのうえで、現場の課題(ユースケース)を起点に、適合性を証明できるデータは何かを考えるべきだとしています(ガートナージャパン)。
従来の基準で高品質とされるデータでも、AI-Readyであるとは限りません。Gartnerは、「従来のデータ品質基準で『高品質』とされるデータが、そのままAI-Readyなデータであるとは限らない」と指摘しています(Gartner)。
Gartnerがこう指摘する理由は、代表性にあります。分析では、人の期待に沿うように外れ値を取り除き、データをクレンジングするのが一般的です。しかしAIには、その用途で起こりうるエラーや外れ値まで含めた、代表性のあるデータが欠かせません。BIのためにきれいに整えた結果、AIに欠かせない代表性が失われることもあるのです。
dotDataは、これとは別の観点からも、「BI-Ready Data(BIのために整えたデータ)はAI-Ready Dataと同じではない」と考えています。それが、データの「意味」です。BIでは、データの意味は画面を見る人が補って解釈します。エージェントの場合は、エージェント自身がデータの意味を正しく理解できなければ、正しい答えを出せません。次の章では、この「意味」がなぜ重要なのかを、具体例で見ていきます。
データの品質とは別に、言葉や数値の「意味」がずれていると、エージェントは正しい計算から誤った答えを出してしまいます。データ整備をBIのための水準にとどめていると、このずれは防げません。
AI-Ready Dataが整っていないまま生成AIやエージェントを使うと、主に次のリスクがあります。
Gartnerは、AI-Readyなデータに支えられていないAIプロジェクトの60%が、2026年までに放棄されると予測しています。同社の調査では、63%の組織が「AIに適したデータ管理の実践を持っていない、または持っているか分からない」と回答しました(Gartner, 2025年2月26日)。
企業の業務部門には、「来月解約しそうな顧客はどこか」「商品Aの売上が下がったのはなぜか」といった問いがあります。こうした問いを、BIツールを操作せずに自然言語で尋ね、答えを得たいというニーズは多くの企業にあります。生成AIの中核であるLLM(大規模言語モデル)とエージェントを使ってプロトタイプを作ると、それらしい答えがすぐに返ってくるため、実現できそうに見えます。しかし本番の運用では、うまくいかないケースが少なくありません。
その原因の1つが、言葉の定義のずれです。「解約」を例に考えてみます。
Aさんはハードな解約を、Bさんはソフトチャーンを思い浮かべて質問しているかもしれません。さらに、エージェントも学習した知識から、独自の「解約」の定義を持っています。全員が「解約」という同じ言葉を使いながら、違う定義のまま分析が進むと、エージェントの答えはもっともらしく見えても、問いとは食い違います。利用者から見ると、ハルシネーション(AIがもっともらしい誤りを生成すること)のように見える誤りです。
この問題は、データをどれだけきれいにクレンジングしても解決しません。顧客データが正しく整備されていても、「解約」の意味が共有されていなければ、正しい答えは得られないからです。エージェントの時代に問われるデータの質とは、データの量や正確さだけでなく、こうした「意味の土台」が整っているかどうかです。
iFoodは、セマンティックレイヤーで指標を標準化し、数字を突き合わせる作業の負荷を減らすとともに、AIアシスタントの精度を高めました。iFoodはラテンアメリカでフードデリバリーのサービスを展開する企業で、この事例はDatabricksが2026年4月に公表したものです。
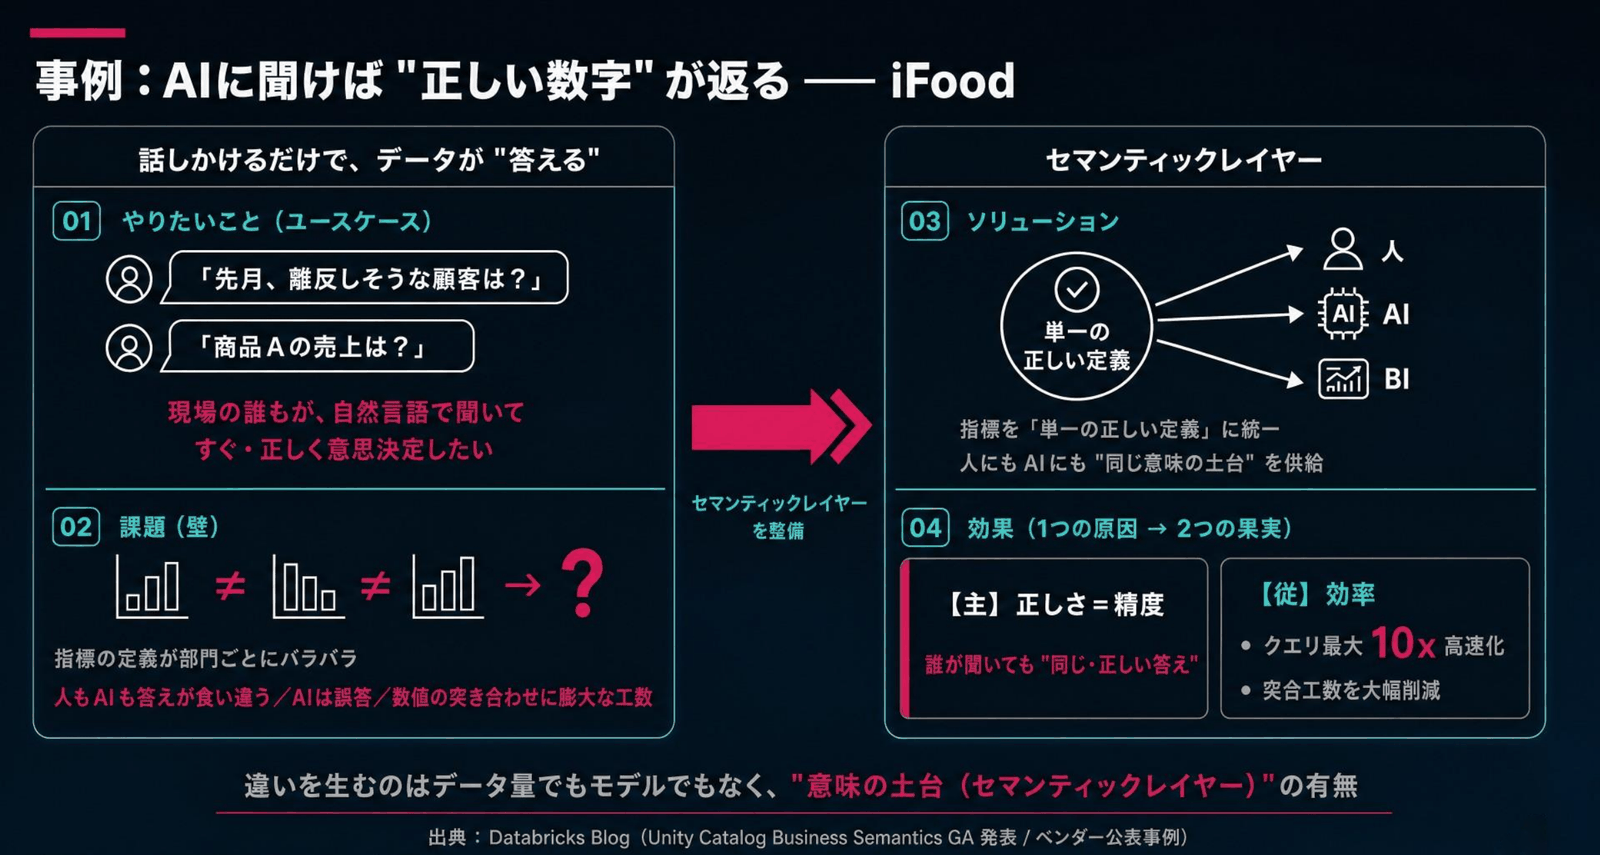
ドイツのファッションEC企業Zalandoも、同じ考え方を取っています。Zalandoによると、ユーザーが「NMV(純商品価値)」を尋ねると、Genieは生のテーブルから計算しようとせず、メトリックビューに登録された管理済みの指標として認識し、定義済みのロジックを参照します(Databricks)。
どちらの例でも、ポイントはモデルではありません。指標の定義を一元化し、人とAIが同じ定義を使えるようにしたことです。
AI-Ready Dataの3層構造とは、BI-Ready Dataの土台の上に、意味を「定義」として固定するセマンティック層と、問いごとに「文脈」を渡すコンテキスト層を重ねる、dotDataの整理です。セマンティックもコンテキストも、どちらもデータの「意味」を扱います。違いは、事前に固定する「定義」か、問いごとに渡す「文脈」かです。そして両者の土台に、BI-Ready Dataがあります。
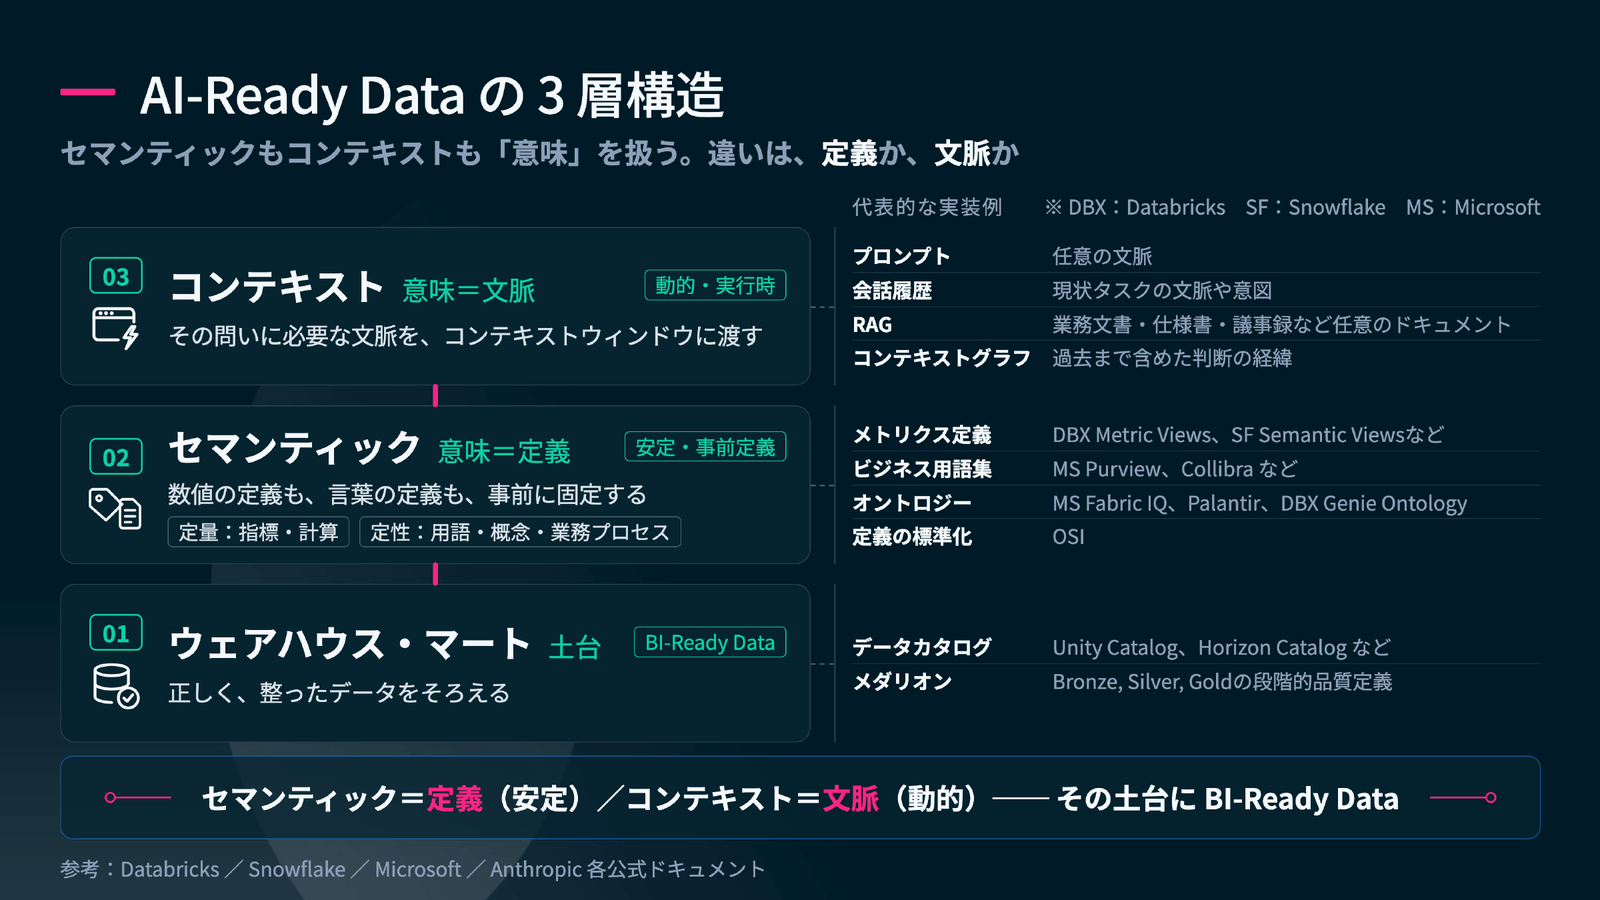
| 層 | 扱う意味 | 性質 | 役割 | 代表的な実装例 |
|---|---|---|---|---|
| ③コンテキスト | 意味=文脈 | 動的。実行時に渡す | その問いに関係する文脈を、エージェントに渡す | プロンプト、会話履歴、RAG、コンテキストグラフ |
| ②セマンティック | 意味=定義 | 安定。事前に定義する | 数値の定義も、言葉の定義も、事前に固定する | メトリクス定義、ビジネス用語集、オントロジー |
| ①土台 | ― | ― | 正しく、整ったデータをそろえる(BI-Ready Data) | データウェアハウス、データマート、データカタログ |
1層目は、正しく整ったデータをそろえる層です。データの構造化、名寄せ、データカタログの整備(Databricks Unity Catalog、Snowflake Horizon Catalogなど)、段階ごとにデータの品質を定義するメダリオンアーキテクチャ(Bronze、Silver、Gold)などが含まれます。
これらは、企業活動のデジタル化とともに、データウェアハウスの時代から取り組まれてきたことです。AIの時代になっても不要にはなりません。AI-Ready Dataの前提条件として、引き続き欠かせない層です。
セマンティックレイヤーとは、指標の計算方法や業務用語の意味を、AIやBIツールが参照できる形で事前に定義しておく層です。数値の定義も言葉の定義も、ここで固定します。定義には、定量的なものと定性的なものがあります。
定量的な定義(指標・計算)の代表は、メトリクス定義です。Databricksのメトリックビュー(Metric Views)やSnowflakeのセマンティックビュー(Semantic Views)がこれにあたります。
たとえば「売上高」を定義する場合、次の3つを決めておきます。
この定義をエージェントが参照できれば、「先月の地域別の売上は?」と聞かれても、エージェントは計算方法を推測しません。定義に従って、該当する区分軸と結合経路をたどり、正しいクエリを組み立てます。誰がどの切り口で尋ねても、同じ「売上高」が返ってきます。先ほどの「解約」の例でいえば、ハードな解約とソフトチャーンを、それぞれ別の名前の指標として定義しておきます。そうすれば、エージェントはAさんとBさんがどちらを指しているのかを区別でき、どちらか曖昧な場合は聞き返すこともできます。
定性的な定義(用語・概念・仕事の流れ)には、ビジネス用語集(Microsoft Purview、Collibraなど)や、オントロジーがあります。オントロジーとは、業務の概念と、概念どうしの関係やルールを、機械が理解できる形で記述したものです。Microsoft Fabric IQやPalantirは、オントロジーを中核に据えています。Databricksも、テーブルやクエリなどから業務のノウハウを自動で抽出する「Genie Ontology」を発表しました(Databricks自身は、これを自動のコンテキスト層と説明しています)。
さらに、こうした定義を製品の垣根を越えて共有するための標準化も進んでいます。Snowflakeなどが2025年9月に立ち上げたOpen Semantic Interchange(OSI)は、2026年1月に仕様が確定し、Databricksも参加しました(Snowflake)。Snowflakeによると、2026年6月時点で54社が参加しています(Snowflake)。その後、Apache Software Foundationのもとで「Apache Ossie(Incubating)」に名称を変えています(Snowflake)。
メタデータとの違いは、説明か、実行できる定義か、という点にあります。テーブルや列の説明(メタデータ)は、これまで主に人が読むためのものでした。いまはエージェントもこれを読み、データの意味を理解する手がかりにしています。セマンティックレイヤーはさらに一歩進み、計算式・区分軸・結合経路のように、エージェントが計算や判断のときにそのまま実行できる形で定義を持ちます。dotDataは、これを「能動的な定義」と呼んでいます。
コンテキスト層は、その問いに関係する文脈を、エージェントのコンテキストウィンドウ(一度に処理できる入力の範囲)に渡す層です。文脈は問いごと、実行ごとに変わります。
たとえば、同じ製品Aの解約分析でも、誰に向けた分析かによって、まとめるべき内容は変わります。製品を販売する営業部門には顧客ごとの対応策、製品を作る製品部門には機能や品質との関係、経営層には事業全体への影響、解約しそうな顧客を担当する営業担当者には具体的な次の一手が役立ちます。データも分析も同じでも、文脈が違えば、提供すべき内容は違ってきます。
Anthropicは、エージェントに何をコンテキストとして渡すかを設計する考え方を「コンテキストエンジニアリング」と呼んでいます。同社は、コンテキストを「足すほど効果が逓減する有限の資源」として扱うべきだとし、コンテキストウィンドウ内のトークンが増えるほど、モデルがその中の情報を正確に思い出す力は落ちると説明しています(Anthropic, 2025年9月)。問いに関係する文脈を、ちょうどよい分量で渡す設計が重要になります。
構造化データにも非構造化データにも、意味の層が欠かせません。AI-Readyかどうかは、構造データか非構造データかとは別の軸で決まるためです。dotDataが企業と議論するなかでは、「ドキュメントなどの非構造データをRAGで扱えるように整備すれば、AI-Readyになる」という考え方をよく聞きますが、RAGの整備だけでは足りません。
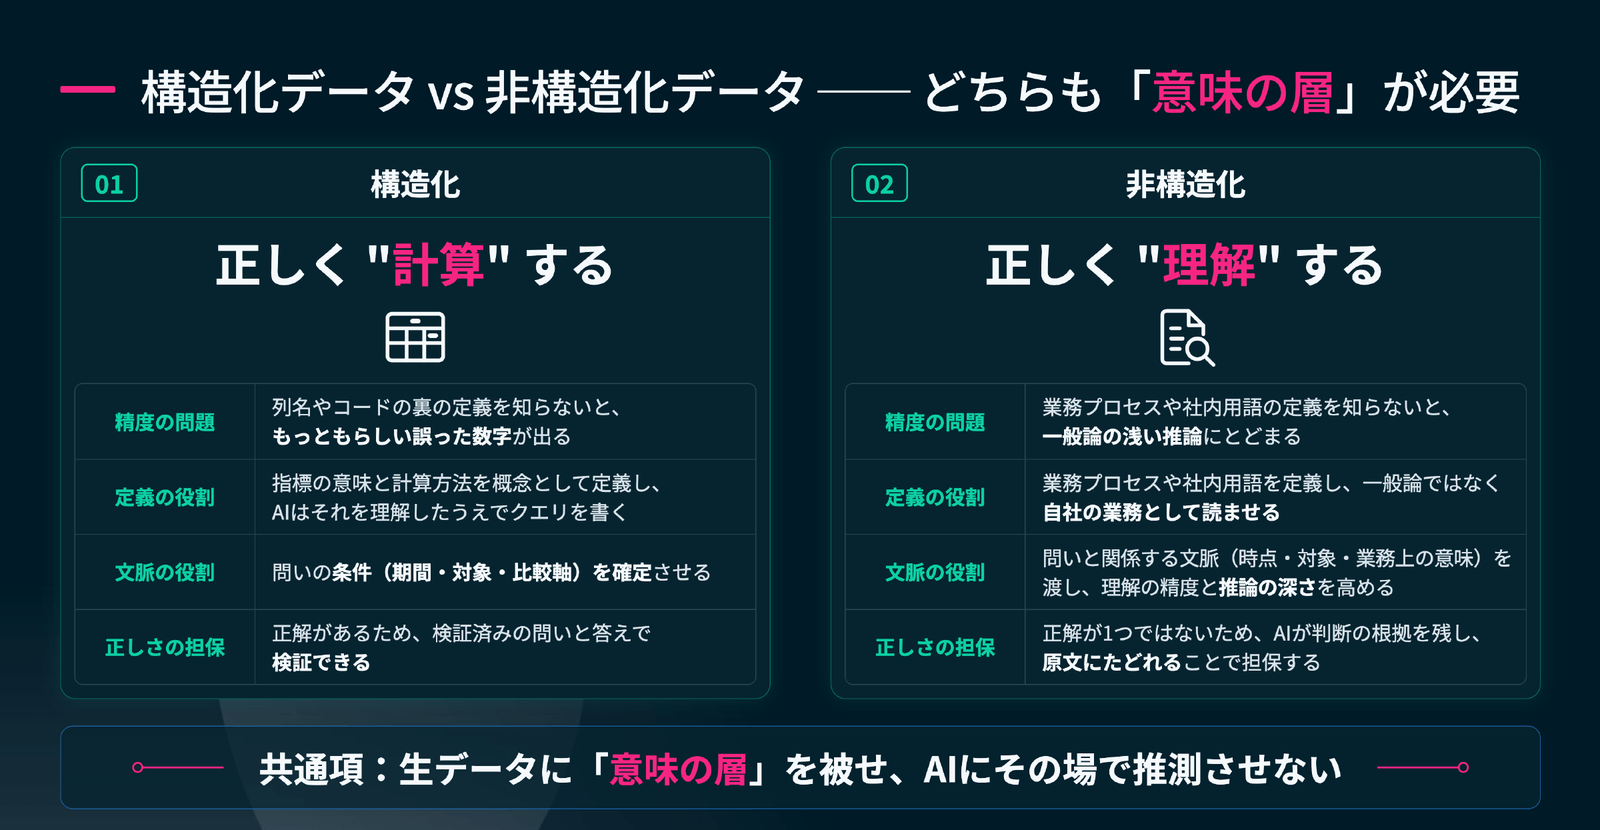
| 観点 | 構造データ | 非構造データ |
|---|---|---|
| AIに期待されること | 正しく「計算」する | 正しく「理解」する |
| 意味の層がない場合の問題 | 列名やコードの裏にある社内固有の定義を知らないと、もっともらしい誤った数字が出る | 社内の手順や用語を知らないと、一般論の浅い推論にとどまる |
| 定義(セマンティック)の役割 | 指標の意味と計算方法を定義し、エージェントはそれを理解したうえでクエリを書く | 社内の手順や用語を定義し、文書を自社のこととして読ませる |
| 文脈(コンテキスト)の役割 | 問いの条件(期間、対象、比較軸)を確定させる | 問いに関係する文脈(時点、対象、意味)を渡し、理解と推論を深める |
| 正しさの担保 | 正解があるため、検証済みの問いと答えで確かめられる | 正解が1つではないため、判断の根拠を残し、原文にたどれるようにする |
構造データでも非構造データでも、共通するのは「生データに意味の層を被せ、エージェントにその場で推測させない」という考え方です。RAGは、非構造データを扱うための有効な手段ですが、意味の層の一部(コンテキストを渡す手段)にすぎません。用語や手順の定義が整っていなければ、検索で取り出した文書を正しく解釈することはできません。
いま、データ基盤ベンダーは「定義」を、AIベンダーは「文脈」を、それぞれ戦略の中核に据え始めています。データ基盤ベンダーの動きは、dotDataのブログ「Snowflake Summit 2025 レポート」や、DatabricksとSnowflakeのガバナンス機能を比較した「攻めと守りを両立する次世代データガバナンス」でも紹介しています。
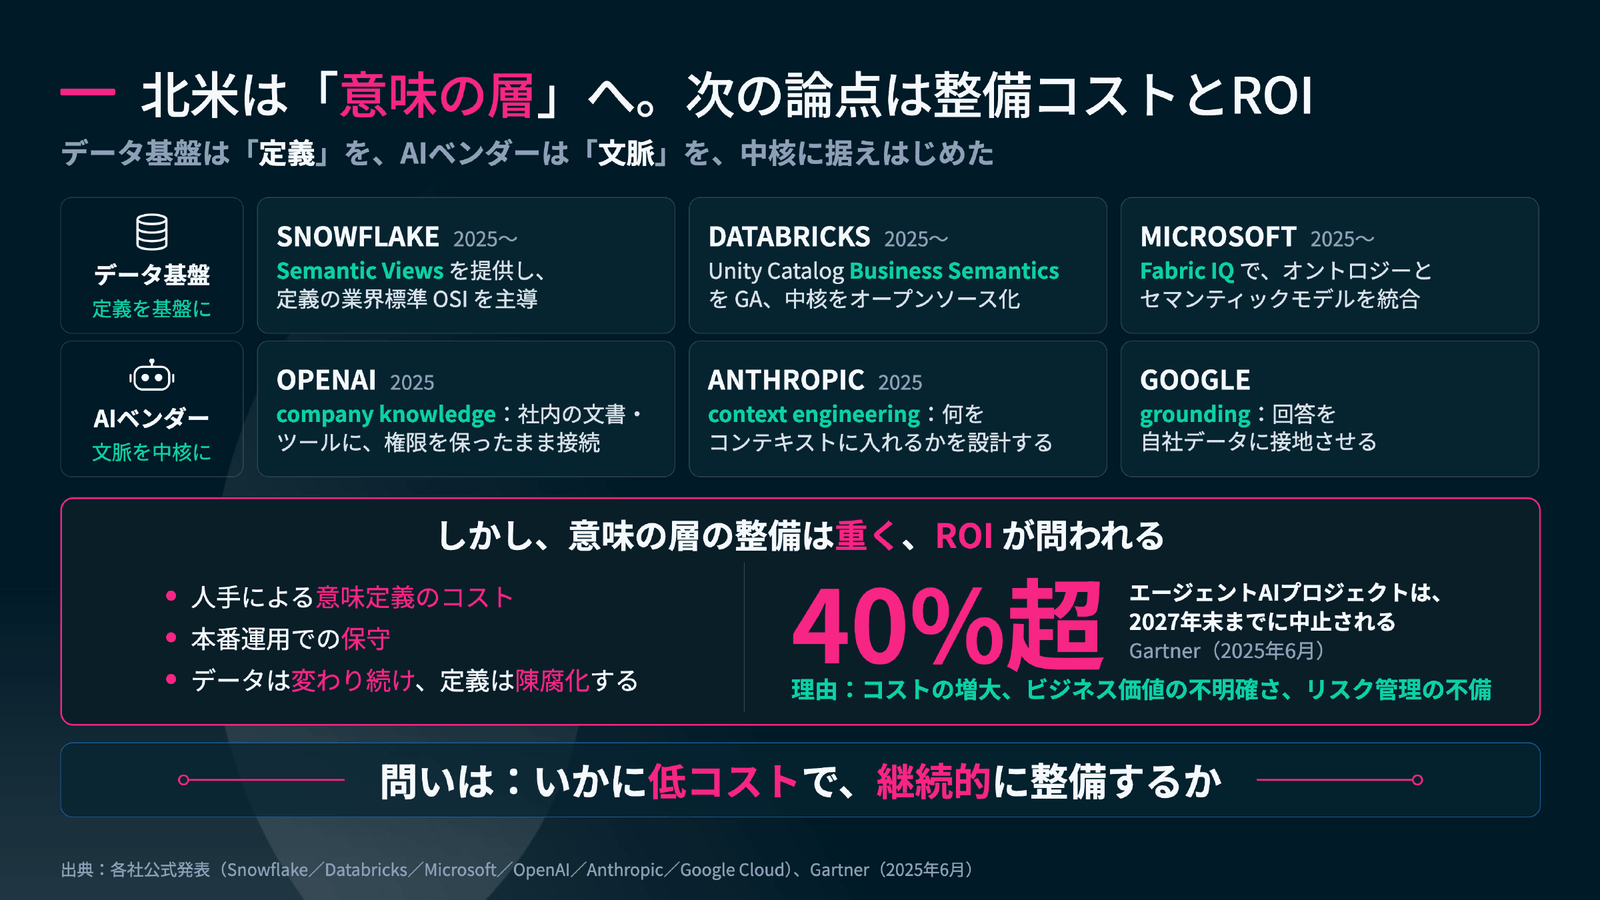
データ基盤ベンダーは、指標や用語の定義を、データ基盤のサービスそのものに組み込み始めています。
AIベンダーは、社内データへの接続と、モデルに渡す文脈の設計を、精度向上の中核に据えています。
意味の層を整えると精度が上がることを示すデータが、各ベンダーから報告されています。いずれもベンダー自身による検証です。
オントロジーは、LLMで下書きを作れるようになったことで、改めて注目されています。オントロジー自体は新しい考え方ではありません。かつてはすべてを人手で記述する必要があり、保守が追いつかずに使いこなせないことが多くありました。いまはLLMにオントロジーの下書きを作らせ、人が確認する進め方が取れるようになりました。
dotDataは、こうした業界の変化をカンファレンスの現場でも見てきました。1年ほど前は、セマンティックやコンテキストが重要だと言われ始めたものの、まだ「1つのクエリがうまくいくかどうか」という雰囲気でした。今年は、1年間取り組んだ結果として、分析の工数が減った、自然言語クエリの誤りが減ったといった成果の発表が目立つようになっています。
意味の層は、LLMで下書きして人が検証し、実行中にも人が文脈を補いながら、継続的に更新して構築・維持します。意味の層を整えた先には、エージェントによる分析という大きな可能性があります。ただし、意味の層は作り込むほど重くなります。次の論点は、いかに低コストで、継続的に整備するかです。
意味の層の整備と維持には、主に3つの課題があります。
Gartnerは、エージェント型AIプロジェクトの40%超が、コストの高騰、ビジネス価値の不明確さ、リスク管理の不備によって、2027年末までに中止されると予測しています(Gartner, 2025年6月)。Gartnerが挙げる理由にデータは含まれていません。ただ、意味の層の整備も同じように、どれだけのコストをかけ、どれだけの価値を得るのか、ROIが問われる段階に入りつつあると、dotDataは考えています。
実務では、次のようなアプローチで、意味の層を作る負担を抑えながら精度を保ちます。
AI-Ready Dataは、AIで解決したい業務を起点に、5つのステップで段階的に整備します。全社のデータを一度にAIのために整える取り組みではありません。生成AIやエージェントで解決したい課題を起点に、そこで使うデータと意味の層を段階的に構築していく取り組みです。dotDataは、企業が導入を進める手順を、次の5つのステップで整理しています。
最初に、エージェントに任せたい仕事と、そこで答えるべき問いを決めます。ガートナージャパンも日本企業に向けた指針の中で、AIで解決する現場の課題を特定し、そのAIに使うデータを見極め、データ品質を評価して必要なら改善し、足りなければ補う、というプロセスをAIごとに繰り返すことが重要だとしています(ガートナージャパン, 2026年5月20日)。用途が決まらなければ、どのデータがAI-Readyかは判断できません。
対象の業務で使うデータが構造化・名寄せされ、データカタログで所在がわかる状態にあるかを確認します。構造化データだけでなく、社内文書などの非構造データも対象です。ここでは、BIのために構築してきたデータ基盤を活かせます。あわせて、外れ値やエラーを取り除きすぎて、用途に欠かせない代表性を失っていないかも確認します。
部門によって解釈が分かれやすい指標(売上、解約、成約など)を、計算式・区分軸・結合経路まで含めて定義します。社内用語や仕事の流れも、用語集やオントロジーとして記述します。熟練者の暗黙知やノウハウになっている判断基準を、エージェントが参照できる定義として書き出すことも、このステップの重要な作業です。
同じデータでも、誰に向けた分析かによって、まとめるべき内容は変わります。エージェントに渡す指示・前提・参照する文書の範囲を、問いの種類ごとに設計します。前述のとおり、渡す情報が多すぎると精度が落ちるため、問いに関係する文脈に絞ることが大切です。
意味の層は、一度作れば終わりではありません。定義の変更を誰が担うのか、誤答に気づいたときに定義をどう直すのかを決め、運用の組織と体制を整えます。データエンジニアやアナリストだけでなく、業務部門でAI活用を推進する担当者も定義づくりに関わると、現場の変化に合わせて定義を更新しやすくなります。意味の定義を担う人材を、データ部門と業務部門の両方に置くことが、AI-Ready Dataを維持する鍵になります。
AI-Ready Dataには、定義と文脈に加えて、データから得られる定量的な知識も欠かせないと、dotDataは考えています。
エージェントが自社の分析で精度を出すには、3種類の知識をそろえることが重要です。LLMが持つ「世界知識」、文書などに書かれた仕事の知見である「ドメイン知識」、そして自社のデータの中にしかない「データからの知識」です。dotDataは、この3つ目を、分析の目的に関係するデータ上のパターン、つまり「特徴量」として捉えています。
特徴量は、これまで主に機械学習モデルの入力として使われてきました。目的に対する定量的な意味を持つため、それ自体がエージェントのためのAI-Ready Dataにもなります。AIを活用した分析で精度の高い答えを得るには、この定量的な根拠が役立ちます。特徴量を目的ごとにどう生成し、エージェントに渡すのかは、AIエージェント時代のデータマートで解説します。dotDataの製品については、dotData Feature FactoryとdotData Insightをご覧ください。
AIエージェントによるデータ分析の全体像はAIエージェントを活用したデータ分析の現在地で解説しています。データ活用の土台となるガバナンスについてはデータガバナンスとは?を、AI時代のガバナンスの全体像はAI時代のデータ活用の鍵を握る「統合データガバナンス」とは?をご覧ください。
着眼点が違います。ビッグデータはデータの量や種類の多さ、データウェアハウスはデータを分析用に統合して蓄積する仕組みを指します。AI-Ready Dataは、量や保管の仕組みではなく、特定の用途に対してAIが正しく使える状態にあるかどうかを指す考え方です。
| 観点 | ビッグデータ | データウェアハウス | AI-Ready Data |
|---|---|---|---|
| 主な関心 | データの量・種類・速さ | 分析用に統合・蓄積されたデータ | 用途に対してAIが正しく使える状態か |
| 主な使い手 | データ基盤・分析の担当者 | BIツールと、それを使う人 | エージェントと、それを使う人 |
| 意味の扱い | 対象外 | 主に人が画面で解釈する | 定義と文脈として、AIが参照できる形で持つ |
データウェアハウスは、AI-Ready Dataの3層構造の土台にあたります。
用途ごとに、その用途での正しさを測って評価します。Gartnerが述べるように、AIへの準備ができているかどうかはデータがどう使われるかによって決まるため(Gartner)、データ単体ではなく、用途に照らして確かめます。構造データでは、正解が分かっている問いと答えの組を用意し、エージェントの回答の正答率を測るのが基本です。非構造データでは、回答の根拠を原文にたどれるかを確認します。運用に入ってからは、LLMを評価者として使う「LLM as a Judge」のような自動評価を組み合わせ、継続的に測ります。
社内のルールで外部への持ち出しが禁じられている情報は、AIにも入力しないのが原則です。たとえば、個人情報やプライバシーに関わる情報、顧客や取引先の機密情報、公開前の経営情報、パスワードなどの認証情報です。エージェントの場合は、人が入力する内容だけでなく、エージェントが自ら参照するデータの範囲も問題になります。エージェントに与える権限を必要な範囲に絞り、データやアクセス権を制御することが基本です。AIエージェント特有のセキュリティのリスクと運用設計の基本は、dotDataのウェビナー「はじめてのAIエージェントセキュリティ〜業務自動化に伴うリスク構造と安全な運用設計〜」で、データの統制の全体像は「データガバナンスとは?」で解説しています。
違いは、説明か、実行できる定義か、という点です。データカタログやメタデータは、どこにどのようなデータがあり、何を表すかを説明する仕組みで、これまでは主に人向けでした。エージェントが読める形で整えれば、セマンティック層の一部として働きます。セマンティックレイヤーはさらに、指標の計算式・区分軸・結合経路のように、エージェントやBIツールが計算や判断にそのまま使える定義まで持ちます。
RAGだけでは不十分です。RAGは、問いに関係する文書を検索してエージェントに渡す、コンテキスト層の手段の1つです。検索した文書を自社のこととして正しく読ませるには、用語や手順の定義(セマンティック層)を別に整えなければなりません。
一部はLLMに任せられるようになりますが、不要にはなりません。テーブルの説明やオントロジーの下書きは、LLMでかなりの精度で作れます。一方、業界やドメインの深い知見が問われる部分や、推論を重ねることで誤差が蓄積する問題を考えると、人による定義と検証は残ります。
頻繁に問われる重要な指標の定義から着手することをおすすめします。売上、解約、成約など、部門によって解釈が分かれやすい指標を、計算式・区分軸・結合経路まで含めて定義します。そうすることで、エージェントの誤答を減らす効果を早く確かめられます。