AIエージェントを活用したデータ分析の現在地 ― 自社データで精度が出ない本当の理由
- 自動化
- データ分析
- 生成AI
- AI業界
 dotData
AIエージェントによるデータ分析は、コーディングに続いてエージェント化が進む領域です。dotDataは、データ分析も今後1〜3年で大きく変わると見ています。ただし、カンファレンスのデモでは鮮やかに動くAIエージェントも、自社のデータに当てると誤答が増えるのが現実です。その原因の多くは、モデルの性能ではなく、エージェントに与えるデータと、そのデータの「意味」の側にあります。
本記事では、次の4点を解説します。
AIエージェントによるデータ分析とは、AIエージェント(AI agent)が業務上の問いを受け取り、複数のデータソースにまたがるデータの探索・加工・集計・解釈・レポート化までを自律的に進める分析の形です。AIを使ったデータ分析(AIデータ分析)のなかでも、手順ごとに人の指示を待たずに、エージェントが分析の手順を自ら組み立てる点が、BIツールやAIアシスタントとの違いです。
エージェントによる分析は、一般的には次の流れで進みます。
この流れを実務で使える水準で回すには、エージェント単体ではなく、次の4つの構成要素をそろえる必要があると、dotDataは考えています。
| 構成要素 | 役割 | 例 |
|---|---|---|
| データ基盤 | 分析の対象となる、正しく整ったデータをそろえる | データウェアハウス、データマート、データカタログ |
| 意味の層 | 指標の計算方法や用語の定義、業務の文脈をエージェントに伝える | 指標の定義、用語集、マニュアルや議事録 |
| AIエージェント | 問いを受けて、探索・加工・集計・解釈・レポート化を進める | 汎用エージェント、データ基盤と連携するエージェント |
| 人の確認と評価 | 要所で方向を修正し、出力の正しさを確かめる | Human-in-the-Loop、LLM as a Judge |
多くの場合につまずくのは、2つ目の「意味の層」です。この点は、本記事の後半で詳しく説明します。
専門知識と判断を必要とする業務から、AIエージェントによる代替が始まっています。最も変化が早いのはソフトウェア開発です。
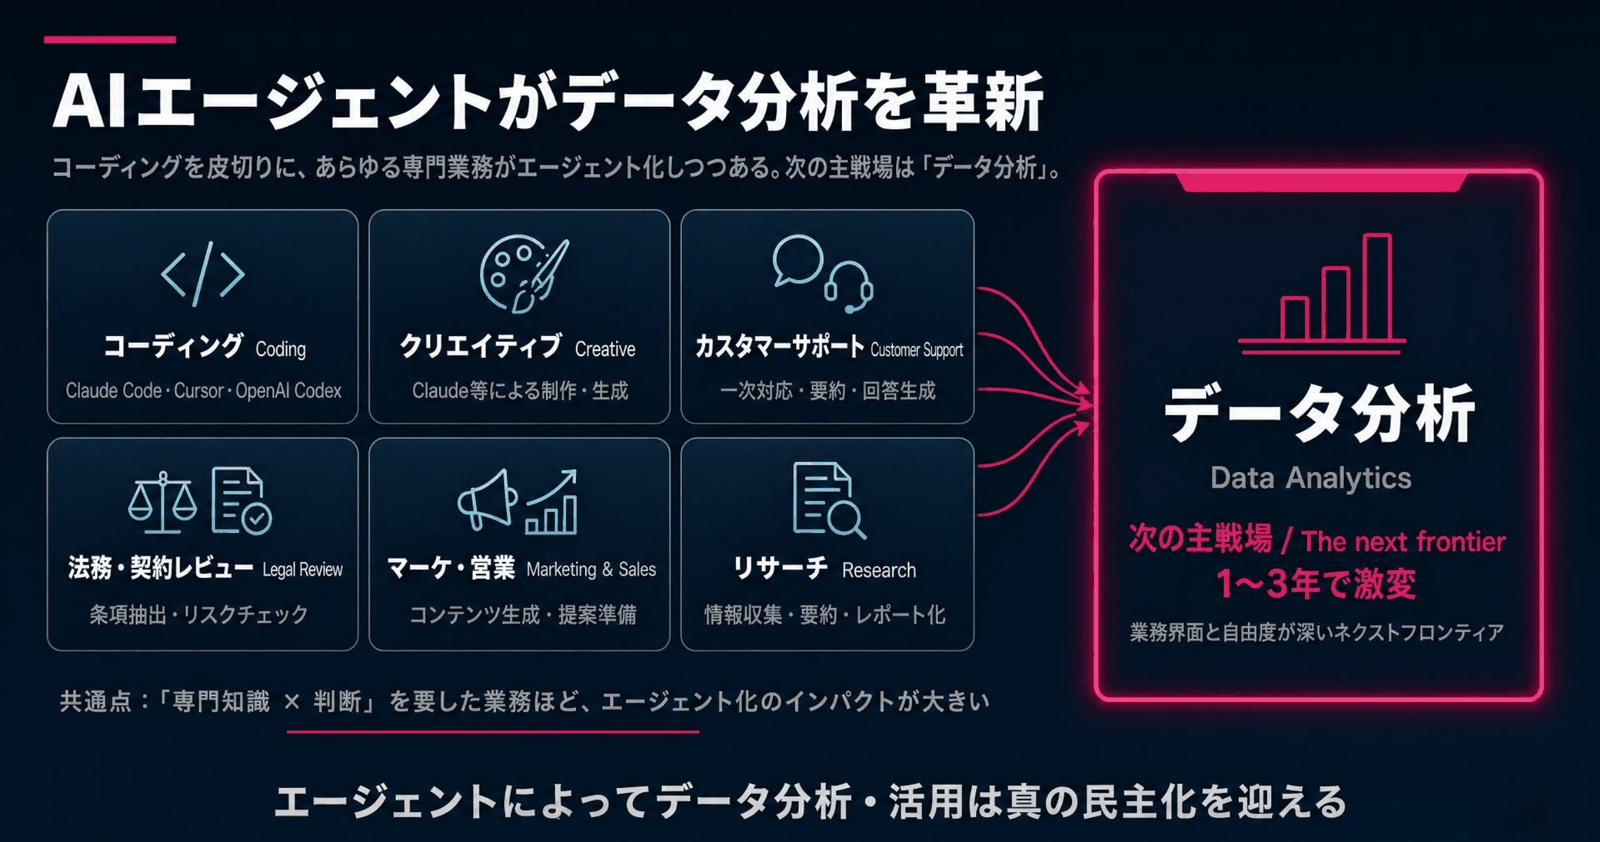
dotDataでも、エンジニアはコーディングエージェントを日常的に使っており、自分でコードを書く時間は大きく減りました。エンジニアの主な仕事は、どのようなソフトウェアをどのようなアーキテクチャで作るかを設計すること、エージェントが書いたコードをレビューすること、そしてエージェントを正しく動かすことに移っています。1年ほど前には「まだ自分たちで書く部分のほうが多い」という声が社内でも聞かれましたが、その状況は短期間で大きく変わりました。
同様の変化は、ほかの専門業務にも広がっています。
| 業務 | エージェントが担い始めている作業 |
|---|---|
| ソフトウェア開発 | コードの生成、テスト、修正 |
| カスタマーサポート | 一次対応、問い合わせの要約、回答の生成 |
| 法務・契約レビュー | 条項の抽出、リスクのチェック |
| リサーチ | 情報収集、要約、レポート化 |
dotDataでは、次に大きく変わるのはUXデザインのようなクリエイティブの分野だと見ています。1年後には、いまのコーディングと同じように、デザイナーの仕事そのものが再定義されているかもしれません。
これらに共通するのは、「専門知識×判断」を必要としてきた点です。専門家にしかできなかった仕事ほど、エージェント化によるインパクトは大きくなります。
データ分析は、業務とデータの両方に深く接しているため、汎用的なAIエージェントだけでは完結しにくい領域です。そのため、コーディングに比べると、エージェントの活用は遅れています。
課題は大きく3つあります。
実際、dotDataが関わっている米国の企業を含め、グローバルに見ても、分析をAIエージェントに全面的に任せ、人が分析をしなくなったという組織は、現時点ではほとんど見られません。
一方で、コーディングやクリエイティブの分野で起きた変化の速さを踏まえると、データ分析も今後1〜3年で大きく変わると、dotDataは考えています。数年後には、人が行う分析よりもAIエージェントが行う分析のほうが多くなる時代が来るでしょう。
分析は、人がツールを使う段階から、AIが人を手伝う段階へと進んできました。その先にあるのが、AIエージェントが自ら分析・判断・実行する段階です。今後1〜3年で、分析の主役は人からAIエージェントへ移っていくと、dotDataは見ています。
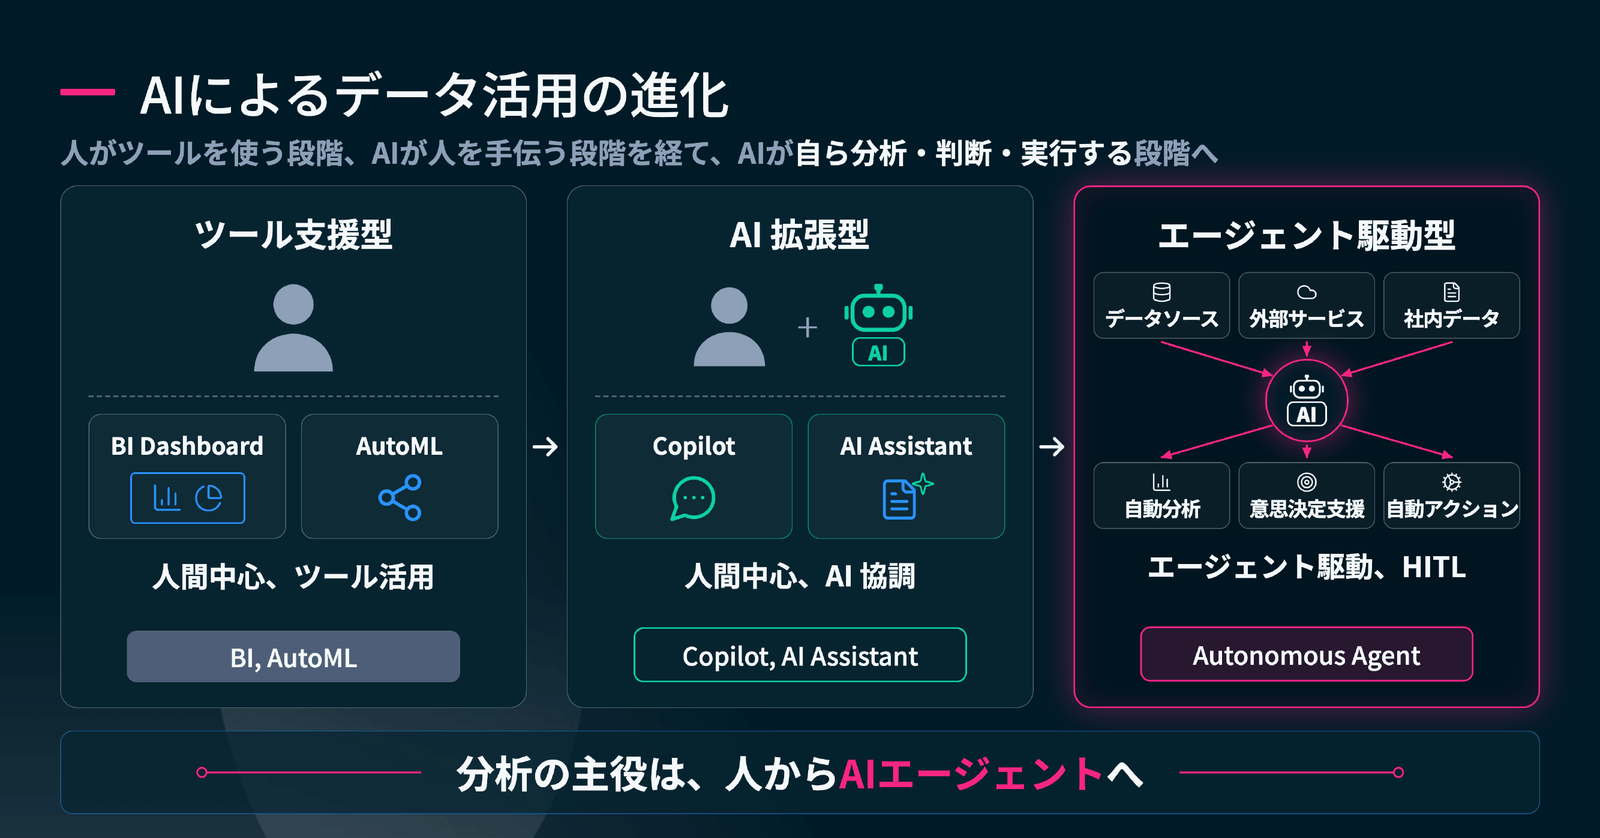
| 段階 | 人とAIの関係 | 代表的な技術 |
|---|---|---|
| ツール支援型 | 人間中心。人がツールを使って分析する | BI、AutoML |
| AI拡張型(現在) | 人間中心。AIが人の分析を手伝う | Copilot、AIアシスタント |
| エージェント駆動型(これから) | AIエージェントが分析・判断・実行を担い、人は方向付けと承認を行う(Human-in-the-Loop) | 自律的に動くAIエージェント |
最初の段階では、ノーコードのBIツールや、機械学習モデルの構築を自動化するAutoML(自動機械学習)が、分析を担う人を支えました。dotDataが2018年に最初に提供した製品も、AutoML製品(dotData Enterprise)です。この段階では、分析の中心はあくまで人でした。
現在は、AIが人の分析を手伝う段階にあります。分析を担う人がチャットで問いかけると、Copilot(人の作業を隣で補助するAI)やAIアシスタントが集計や可視化を手伝います。Databricks GenieやSnowflake Intelligenceのように、データ基盤上でAIに自然言語で問いかける製品が代表例です。
次の段階では、繰り返し行う分析をエージェントが担い、人は要所で方向付けと承認を担います。この関わり方を、Human-in-the-Loop(HITL)と呼びます。
AIエージェントをデータ分析に活用する最大のメリットは、組織の中で繰り返し発生する数多くの分析を、人手に頼らず回せるようになることです。具体的には、次のような効果が期待できます。
ただし、こうした効果は、エージェントの分析が正しいことが前提です。後半では、その前提を崩す要因を見ていきます。
こうした取り組みは、自然言語でデータに問い合わせる機能から始まっています。ここでは、データ基盤ベンダーのSnowflakeが公表している2つの事例を紹介します(いずれもベンダー公表の事例です)。
2つの事例に共通するのは、問いと指標がはっきりした分析から始めている点です。誰に向けて、どの指標について答えるのかが明確であるほど、エージェントの答えを検証しやすくなります。
なお、Snowflakeは2026年8月に、Cortex Analystからエージェントの機能であるCortex Agentsへの移行を推奨すると発表しています(Snowflake Docs, 2026年8月)。自然言語での問い合わせから、エージェントによる分析へと、製品の重心が移りつつあることがうかがえます。
エージェントを分析に使うアプローチは、大きく3つに分けられます。いまの製品の多くはAIが人を手伝う形で使われていますが、エージェントが自ら分析する形へと機能を広げつつあると、dotDataは見ています。どのアプローチを選んでも、データ分析エージェントの答えの正しさを左右するのは、エージェントに与えるデータとコンテキスト(文脈)の質です。
| アプローチ | 代表例 | 得意なこと | 前提・制約 |
|---|---|---|---|
| 汎用エージェント・コーディングエージェント | ChatGPT、Claude、Gemini/Claude Code、OpenAI Codex、Cursor | 柔軟に使え、PythonやSQLで分析用のコードも書ける | 自社データの意味は知らない。成果が使う人のスキルに左右される |
| データ基盤連動型 | Databricks Genie、Snowflake Intelligence | 基盤上のデータに直接アクセスでき、権限管理の下で使える | 正しさは、基盤上に整備された定義の充実度に左右される |
| 業務・分析アプリ | Salesforce Agentforceなど業務アプリと連携するエージェント、特定目的の分析エージェント | 特定の業務や目的に合わせて作り込まれている | 対象とする範囲が限られる |
ツールの選び方は、本記事末尾のFAQで整理しています。いずれのアプローチでも、エージェントが自社データの意味を理解していなければ、正しい答えは返りません。この点が、次に述べる「期待と現実」のギャップにつながります。
自社データで精度が落ちる主な要因は、次の4つです。
こうしたリスクを放置したまま進めると、プロジェクトそのものが続かなくなるおそれがあります。Gartnerは、エージェント型AIプロジェクトの40%超が、コストの高騰、ビジネス価値の不明確さ、リスク管理の不備により、2027年末までに中止されると予測しています(Gartner, 2025年6月)。
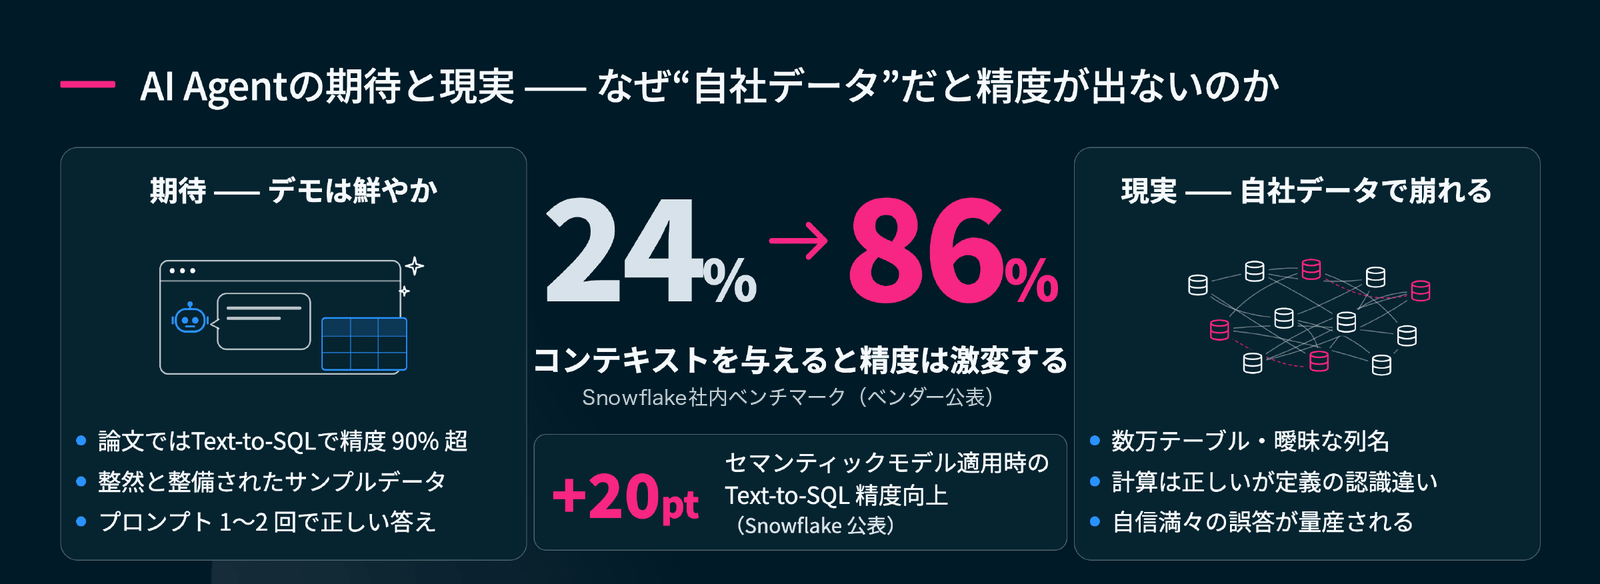
dotDataも参加した2026年6月のData + AI Summit 2026をはじめ、データ基盤ベンダーのカンファレンスでは、AIエージェントが分析を次々にこなす華やかなデモが披露されます。学術的なベンチマークでも高い数字が並びます。自然言語の質問をSQLに変換するText-to-SQLの代表的なベンチマーク「Spider 1.0」では、2023年時点で実行精度91.2%が報告されています(Spider)。
一方、実際の企業のデータベースを模したベンチマーク「Spider 2.0」の論文(2024年11月公開、ICLR 2025採択)では、当時のo1-previewを使ったエージェントでも、解けたタスクは21.3%にとどまりました(Lei et al., 2024)。同じ論文は、Spider 1.0では91.2%、BIRDでは73.0%だったと比較しています。
その後、Spider 2.0のリーダーボード(Snowflake環境版のSpider 2.0-Snow)では、スキーマの理解や文脈の与え方を作り込んだエージェントシステムが、90%台のスコアを報告しています(自己申告の値)(Spider 2.0)。LLMを単体で使うか、文脈を作り込むかで、成績が大きく変わることを示唆しています。
ベンチマークと実務の差を生むのは、実際のデータが持つ次のような特徴です。
計算が正しくても答えが違ってしまうのは、人とエージェントが同じ言葉を別の定義で使っているからです。自社データでの誤答のうち、特に気づきにくいのがこのケースです。
たとえば「来月解約しそうな顧客は?」と尋ねたとします。「解約」には、次のように複数の定義がありえます。
人とエージェントが別々の「解約」を思い浮かべたまま分析が進むと、計算自体は正しくても、問いとは違う答えが返ってきます。しかもその答えはもっともらしく見えるため、使う側は誤りに気づけません。
この誤りは、プロンプト(エージェントへの指示文)を工夫するだけでは防ぎきれません。指示がどれほど丁寧でも、指標の定義や業務の文脈がエージェントに共有されていなければ、エージェントは自分なりの解釈で計算を進めてしまうからです。この問題は、AI-Ready Dataとはで詳しく解説します。
データが大規模になると、エージェントは必要なデータや文書を探すだけで時間とコストを使います。DatabricksのAli Ghodsi CEOは、2026年6月のData + AI Summit 2026の基調講演で、エージェントがどこを探せばよいか分からないまま、その場で探し回るため、答えが返るまでに10〜15分かかることがあると指摘しました(Databricks)。
最新の大規模言語モデル(LLM)は、一般的なタスクをこなすうえで十分な推論力を備えていると、dotDataは考えています。自社データで誤答が増える主な原因は、モデルではなく、エージェントが参照する入力の側にあります。
データ基盤ベンダーの検証でも、この傾向が示されています。Snowflakeは、自社のプロダクト分析に関する58問の社内ベンチマークの結果を公表しています。業務のコンテキストを持たないまま、Snowflake MCP経由でデータにアクセスしたエージェント(Claude Code)の正答率は24.1%でした。MCPは、AIエージェントを外部のデータやツールと連携させるための標準規格で、Snowflake MCPはそのSnowflake用の接続口です。これに対し、コンテキストを与える機能(Cortex Sense)を使ったSnowflakeのエージェントでは86.3%でした(Snowflake, 2026年6月、Snowflake Engineering Blog, 2026年8月)。ベンダー自身による測定で、比較したエージェントの構成も異なるため、単純な比較ではありません。それでも、コンテキストの有無で正答率が大きく変わりうることを示す例です。
Snowflakeは2026年6月のSnowflake Summit 26の基調講演でも、差別化の源泉はAIモデルではなく自社のデータにある、というメッセージを打ち出しています(Snowflake Summit 26 Keynote)。
調査会社も同様の見方を示しています。
新しい技術が登場するたびに、同じことが起きてきました。BIの時代も機械学習の時代も、最初はツールやモデルに注目が集まりました。しかし、その性能が一定の水準に達すると、成否を分けるのは入力データの整備になりました。
AIエージェントの時代も同じ構図です。ただし、今回はデータをきれいに整えるだけでは足りません。エージェントがデータの「意味」を理解できるようにする必要があります。これが、近年注目されている「AI-Ready Data」という考え方です。詳しくはAI-Ready Dataとはで解説します。
導入は、LLMを選ぶ前に、対象業務、データの意味、人の関与、評価の方法を順に整えることから始めます。次の4つのステップで進めることを、dotDataは推奨します。
1つの定型分析でこの4ステップを回し、正しさを確かめてから、対象とする分析テーマを組織全体に広げていくのが現実的な進め方です。
dotDataは、データの中にあるパターンである「特徴量」を、AIエージェントが使える定量的な根拠として提供することに取り組んでいます。特徴量とは、分析の目的に関係するデータ上のパターンです。たとえば、ローンを利用しそうな顧客に共通する行動パターンなどが、これにあたります。
AIエージェントが自社の分析で正しい答えを出すには、LLMが持つ世界知識や、文書に書かれたドメイン知識に加えて、自社のデータからしか得られない「データからの知識」が必要です。dotDataは、特徴量自動設計の技術によって、目的ごとに数多くのパターンをデータから網羅的に探索し、エージェントが使える形で提供する取り組みを、顧客とともに進めています。この考え方は、AIエージェント時代のデータマートで詳しく解説します。
特徴量と生成AIを活用したビジネスアナリティクスについては、dotData Insightをご覧ください。
データの「意味」をどう整えるかはAI-Ready Dataとはで、エージェントに定量的な根拠を与える方法はAIエージェント時代のデータマートで解説しています。
分析を主導するのが人か、エージェントか、という点が違います。BIアシスタントは、人の指示に応じて集計や可視化を手伝います。データ分析AIエージェントは、問いを受けて分析の手順を自ら組み立て、データの探索から加工・集計、解釈、レポート化までを進めます。人は、方向付けと承認を担います。Databricks GenieやSnowflake Intelligenceのように、データ基盤上の製品も、対話による補助からエージェントによる分析へと機能を広げつつあると、dotDataは見ています。
分析の種類、データの所在、使う人、求められる正確さ、意味の層の整備状況の5つを基準に選びます。
たとえば、リテラシーの高い分析チームが自由に探索するなら汎用エージェント、全社で同じ指標を使ってセルフサービス分析をするならデータ基盤と連携するエージェント、という使い分けが可能です。
エージェントに与える権限を必要な範囲に絞ることが基本です。AIエージェントは自律的にデータへアクセスし、操作を実行するため、従来のセキュリティ教育やアクセス管理だけでは、意図しない操作のリスクを防ぎきれません。権限の最小化に加えて、データやアクセス権の制御によってリスクを防ぐ考え方が必要になります。AIエージェント特有のリスク構造と安全な運用設計の基本は、dotDataのウェビナー「はじめてのAIエージェントセキュリティ〜業務自動化に伴うリスク構造と安全な運用設計〜」で解説しています。
正解が分かっている問いで確かめるのが基本です。指標の定義がはっきりした定型分析について、正しい答えが分かっている問いと答えの組を用意し、エージェントの回答と照合して、正答率や誤りの傾向を確認します。Snowflakeが58問の社内ベンチマークで正答率を比べたように、まずは数十問程度の評価セットから始めると、改善の効果を比べやすくなります。運用に入ってからは、LLM as a Judgeのような自動評価を組み合わせ、正しさを継続的に測ることが可能です。
導入費用は、ツールの利用料よりも、データと意味の層をどこまで整える必要があるかによって大きく変わります。主な要因は次の5つです。
仕事がなくなるのではなく、役割が変わると考えられます。定型的な分析はエージェントに移っていきます。人の役割は、問いを立てること、アドホックで複雑な分析をすること、エージェントの分析を判断すること、エージェントを監督することに移っていきます。特に、エージェントが参照する指標の定義や業務の文脈を整える仕事は、データアナリストの知見が最も生きる領域になると、dotDataは考えています。